一场网络故障导致Outlook。Teams、Copilot及Microsoft 365多项功能中断超过一天,影响全球多个地区的用户。微软表示,问题源于一次网络变更,恢复工作已取得进展,但据其官方状态页面显示,截至11月14日仍存在服务降级。微软在官方声明中排除了网络攻击的可能性,也否认与人工智能系统存在关联,完整的技术原因将在事后报告中公布。
本文参考了微软公开状态页面、美联社的更新报道以及Sky News的相关报道。据美联社报道,Downdetector平台上来自74个国家的用户投诉量远超平均水平,但这些数据来自用户自主提交,并非受影响人数的官方统计。
故障波及邮件、协作与Copilot
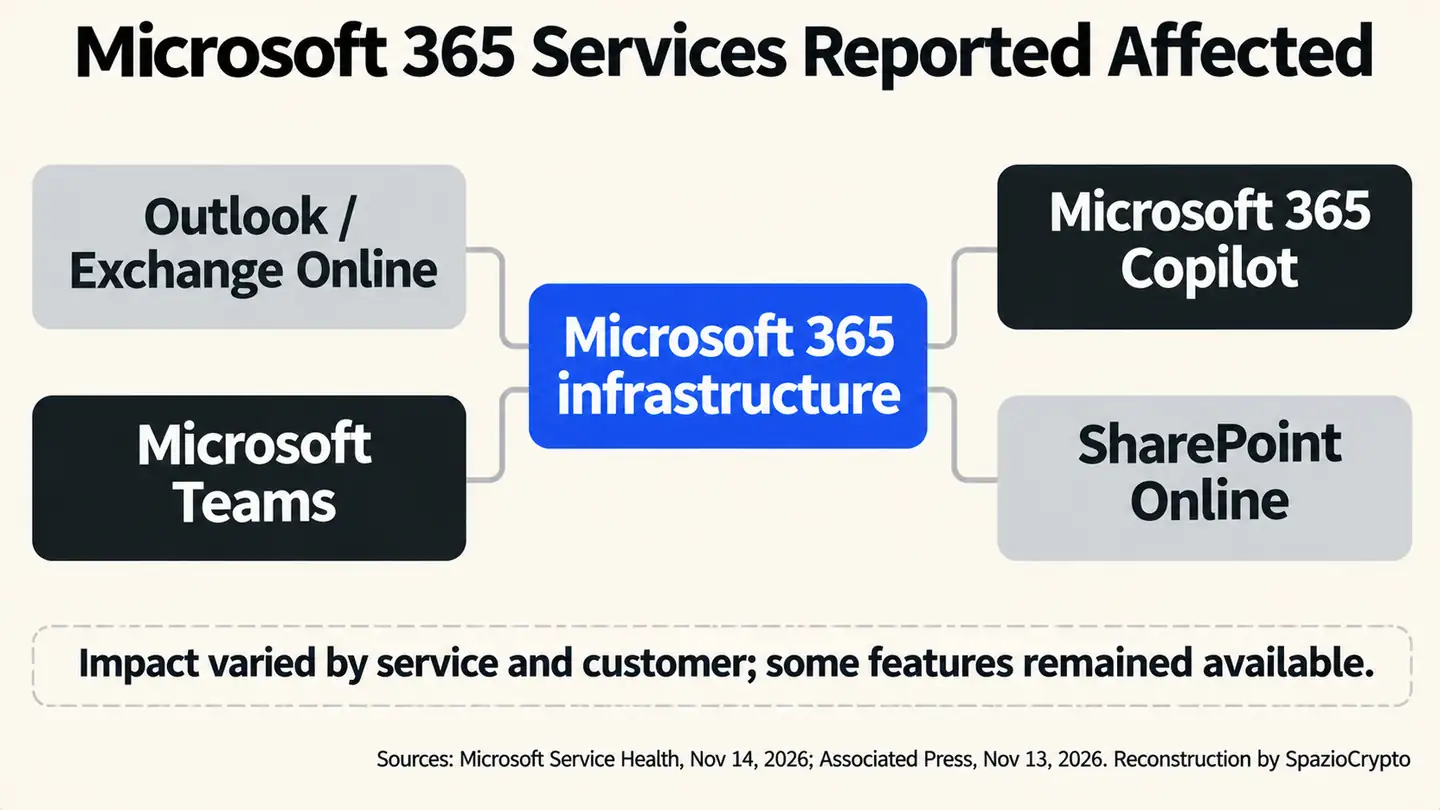
此次事故于11月12日开始,影响Microsoft 365多个组件。受影响的服务包括Exchange Online与Outlook、Teams、Copilot、SharePoint,以及部分管理和生产力功能。各产品受影响程度不尽相同:微软指出,依赖邮件和Exchange服务的功能出现降级,而与上述系统无关的部分功能仍可正常使用。
用户反映的问题包括邮箱访问困难、邮件投递延迟,以及部分协作和AI辅助功能中断。微软状态页面提示,在恢复工作持续推进期间,部分用户可能仍会遇到间歇性访问问题或收到延迟邮件。
此次事件最值得关注的特点,是故障在不同产品间的传播方式。云服务并非由相互独立的应用组成。身份认证、网络、邮件、存储和后端服务往往同时支撑多个工具。当共享层出现能力下降或响应异常时。影响可能出现在用户认为彼此独立的产品上。
这并不意味着微软所有服务均不可用,或Azure发生了全面中断。此次记录在案的故障仅涉及Microsoft 365的特定功能。且不同地区和产品受影响程度各有差异。SpazioCrypto的数据中心专题页面持续收录支撑云服务与AI基础设施的相关资讯。
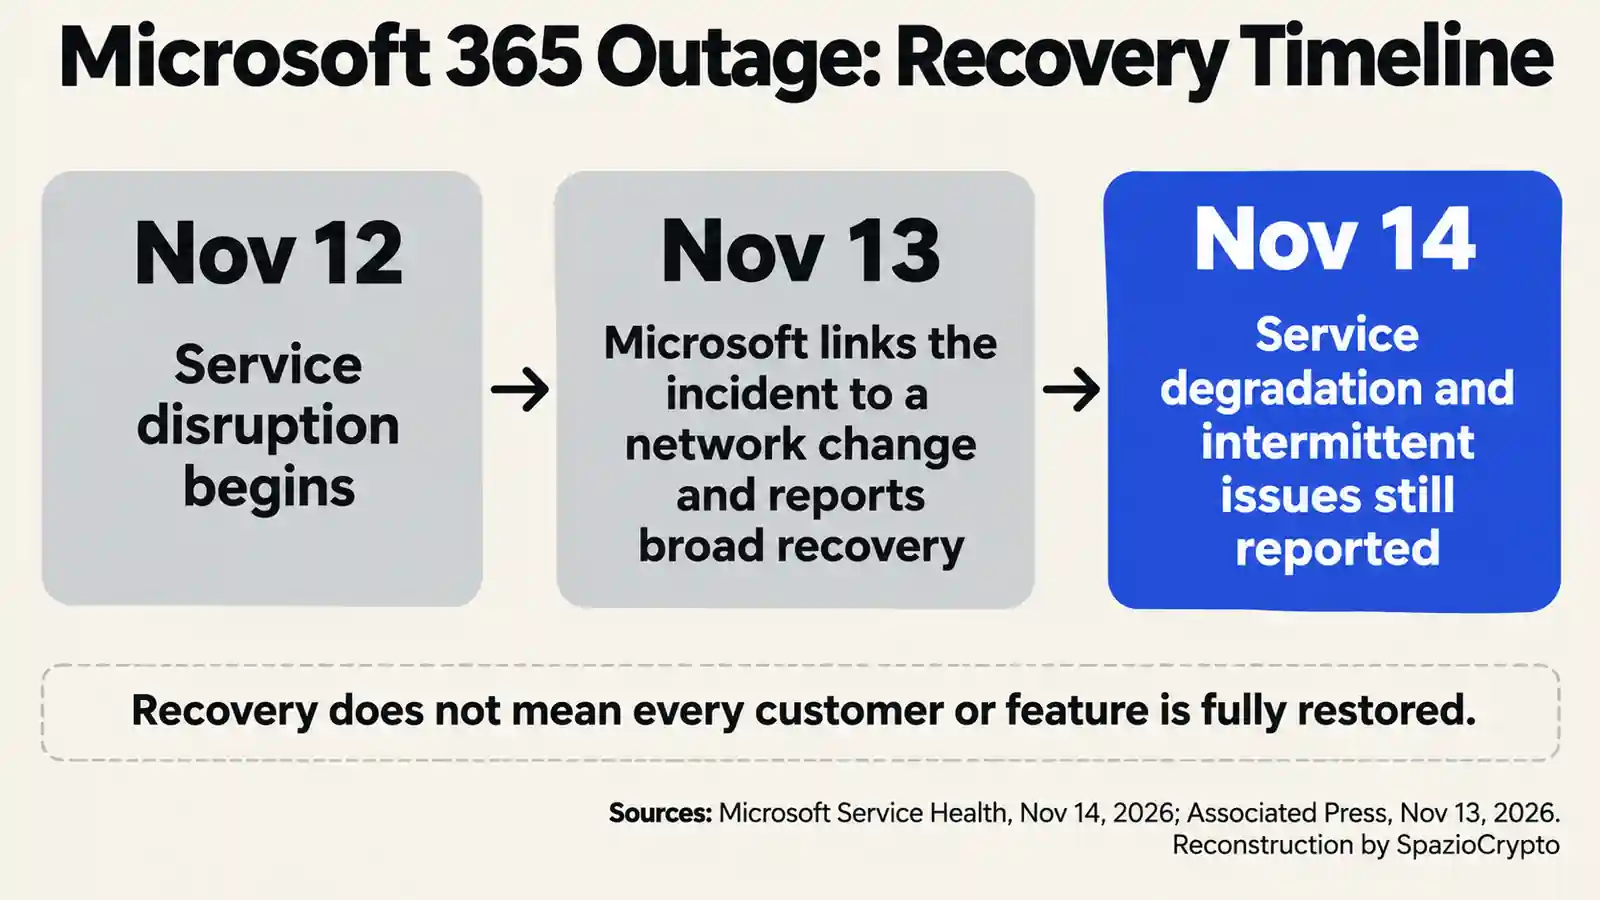
微软将故障归因于网络变更
说白了,在11月13日的更新中。微软将此次事件定性为技术故障,与网络攻击、AI或智能代理均无关。微软表示,此前一次网络容量升级遗留的问题,在随后一次变更操作后被触发。工程师随即展开工作。着力恢复服务容量、修复受影响系统,并逐步将各服务恢复至稳定水平。
上述官方表述明确了事件类型,但尚不构成对根本原因的完整技术分析。微软表示,将在问题缓解后发布事后报告,详述根本原因及预防措施。在此之前,有关具体配置、受影响组件及错误发生顺序的信息,均不应视为已经查明的事实。
排除网络攻击的结论同样出自微软方面。微软声明,目前没有发现与本次故障相关的恶意活动证据。这一信息具有参考价值。但不能替代最终报告,也无法替代独立核实。早期网络上流传的各种猜测,均不构成对故障起源的证明。
区分技术故障与安全事件,对用户和企业组织而言至关重要。技术故障的主要风险通常是服务可用性;而安全事件则可能进一步涉及未授权访问或数据泄露。就目前微软公开信息而言,此次事件属于可用性和容量层面的故障,不涉及数据泄露。
恢复范围广泛,但影响尚未完全消除
实际上,据美联社2026年11月13日报道。微软表示在北美、欧洲和亚太地区观察到服务逐步恢复并趋于稳定。电子邮件队列正向正常水平回归,但部分用户仍可能遭遇间歇性访问故障和延迟。11月14日,微软365公开状态页面仍显示服务降级,因此服务恢复不应与事件正式关闭相混淆。
此次事故的运营影响远不止个人层面的不便。美联社收集了来自多个国家企业和公共机构的中断报告。涉及依赖邮件进行沟通和流程管理的组织。各机构所受影响程度不一:并非所有功能都停止运转。也并非每个被提及的机构都经历了关键性中断。
据美联社数据,Microsoft 365目前拥有超过4.5亿个商业付费订阅。这一数字有助于理解平台故障的潜在规模,但并不代表此次事件实际波及的用户数量。微软方面未公布经过核实的受影响账户总数。
此次事件再度将企业对少数云服务商和生产力工具供应商的依赖问题推到聚光灯下。欧洲监管机构此前已多次就数字服务和AI能力向欧盟以外运营商集中的风险发出警示,相关分析可参见SpazioCrypto关于欧洲金融依赖境外数字基础设施的深度报道。仅凭这一事件本身尚不足以证明系统性风险,但它确实说明了业务连续性计划和备用系统为何值得进行实际测试。
业务韧性有赖于完善的连续性计划
任何组织都无法完全避免外部供应商的故障,但可以降低运营冲击。需要核查的措施包括:紧急通信的替代流程、关键联系人的离线备份、数据的独立导出与存储、应急角色分配,以及平台恢复后的快速复工方案。仅有书面计划远远不够,必须在不依赖可能发生故障的服务的前提下进行实际演练。
这一议题同样涉及数字经济的物理基础结构。微软及其他超大规模云服务商数据中心的扩张,通常从能源消耗和算力角度加以讨论;但可靠性、冗余设计和互联结构同样是这一基础设施不可或缺的组成部分。越多服务共享同一平台,就越有必要厘清哪些依赖关系相互重叠、哪些备用方案真正具备独立性。
云服务的持续增长,也使跨多基础设施分配负载和数据的能力愈发具有战略价值。IREN向AI数据中心领域的扩张,以及全球AI基础设施建设竞赛,都表明算力、能源与地理布局正成为数字服务的核心要素。冗余能力并非简单购置更多服务器即可实现,系统之间的物理隔离以及切换至备用供应商的实际可行性同样至关重要。
与此同时,多云架构方案的评估需要保持审慎。若身份验证、邮件、备份或内部流程仍集中于同一故障节点,引入第二家供应商并不能确保业务连续性。即便是像OpenAI模型在Google Cloud上的预览部署这类多云访问形式,也不能自动等同于灾难恢复策略,后者需要专门的架构设计和测试验证。
Microsoft 365 事件摘要
Microsoft 365 事件摘要
已确认事项与待确认事项
- 已确认:微软已通报一起波及多项Microsoft 365服务的事故,并持续就恢复进展进行沟通。
- 尚未披露:受影响用户的核实总数,以及完整的根本原因分析,微软承诺将在缓解措施完成后予以记录公布。
- 持续关注:事故正式关闭时间、事后复盘报告,以及邮件等相关功能的稳定恢复情况。
更宏观的视角
换句话说,本文作为编辑观点明确声明:此次事件揭示了高度集中化的运营代价。一次网络变更,可以同时波及共享组件与基础设施的多种服务工具。这并不能证明云计算本身不可靠。也不意味着微软的冗余设计存在根本缺陷。要评估根本原因与纠正措施,仍需等待官方技术报告。
接下来值得关注的信号包括:事故正式关闭公告、技术故障序列的详细说明,以及微软宣布的预防措施。对于企业客户而言,最实际的检验是:当电子邮件、协作工具与文件访问同时依赖单一生态系统时,紧急预案能否真正发挥作用。
资料来源
换句话说,服务状态及恢复进展:微软服务健康状态页面,2026年11月14日查阅。国际影响范围、服务恢复情况及服务依赖分析:美联社,2026年11月13日。微软就技术原因及恢复过程的官方声明:天空新闻,2026年11月13日。