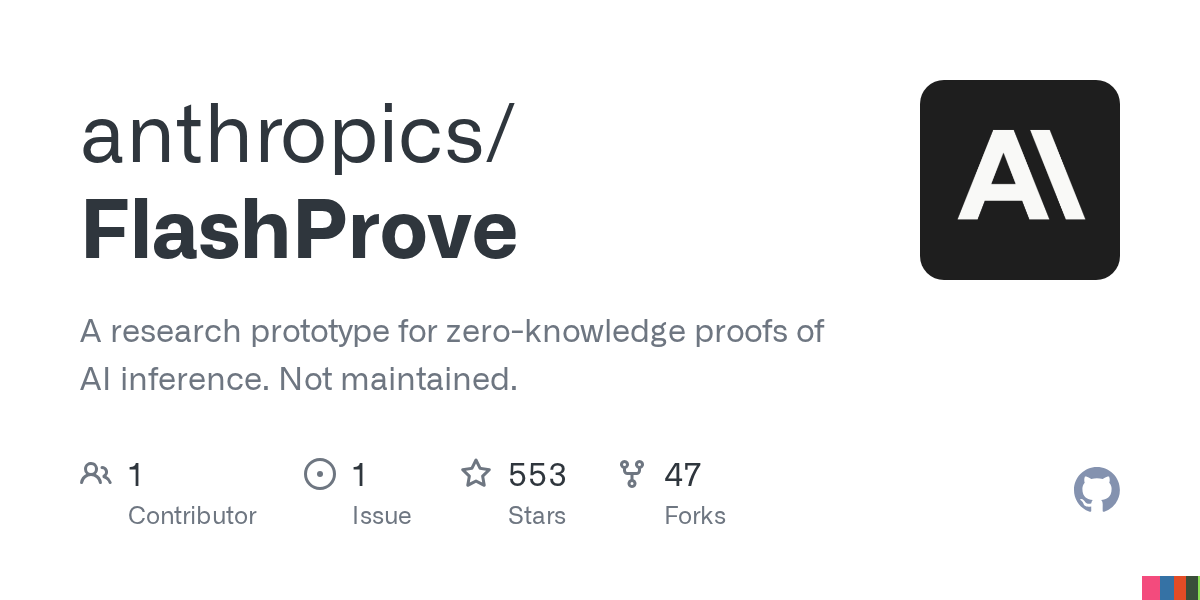
当一家供应商声称其服务使用了某个特定的人工智能模型,客户如何确认这一点?2026年11月2日,Anthropic发布了FlashProve,这是一个开源原型,能够生成密码学证明,用以验证某条响应确实由特定模型生成,同时不泄露模型权重。演示基于4位量化版本的Llama 4 Maverick,输入窗口为1024个token。FlashProve目前并非Claude API的正式服务,代码仓库也已声明不再维护。
SpazioCrypto研究团队阅读了Anthropic发布的研究帖子,该帖子由Anthropic内部研究员与EPFL、MIT的学者联合署名,同时参考了GitHub公开仓库的README文档。Anthropic于11月3日在X平台发布的公告帖无法通过我们的工具打开。以下引用的性能数据均由Anthropic方面声明,尚未经过第三方独立测量。
New Anthropic research: progress on provable inference for large language models.
,Anthropic (@AnthropicAI) November 3, 2026
Here, we introduce FlashProve. Building on established cryptographic techniques, FlashProve allows developers to verify whether a given response came from a given AI model. It's substantially more…
问题核心:响应究竟来自哪个模型
根据Anthropic的研究帖子,目前用户无法验证响应是否来自开发者所声明的模型。研究指出两类风险:其一是路由服务可能将承诺的模型替换为更廉价的版本;其二是针对模型与用户之间token流的中间人攻击。对于通过中间平台采购AI服务的企业客户而言,这个问题相当实际,他们付费购买某一特定模型,却没有任何手段核实实际运行的究竟是哪个模型。
随着AI分发渠道不断增多,这一问题也愈发突出。从云平台转售第三方模型(如OpenAI入驻Google Cloud),到同一开源权重模型由多家供应商以不同价格提供(如MiniMax的Flash版本),模型来源的可信度正在成为行业关注的焦点。
技术原理:承诺、证明、验证三步走
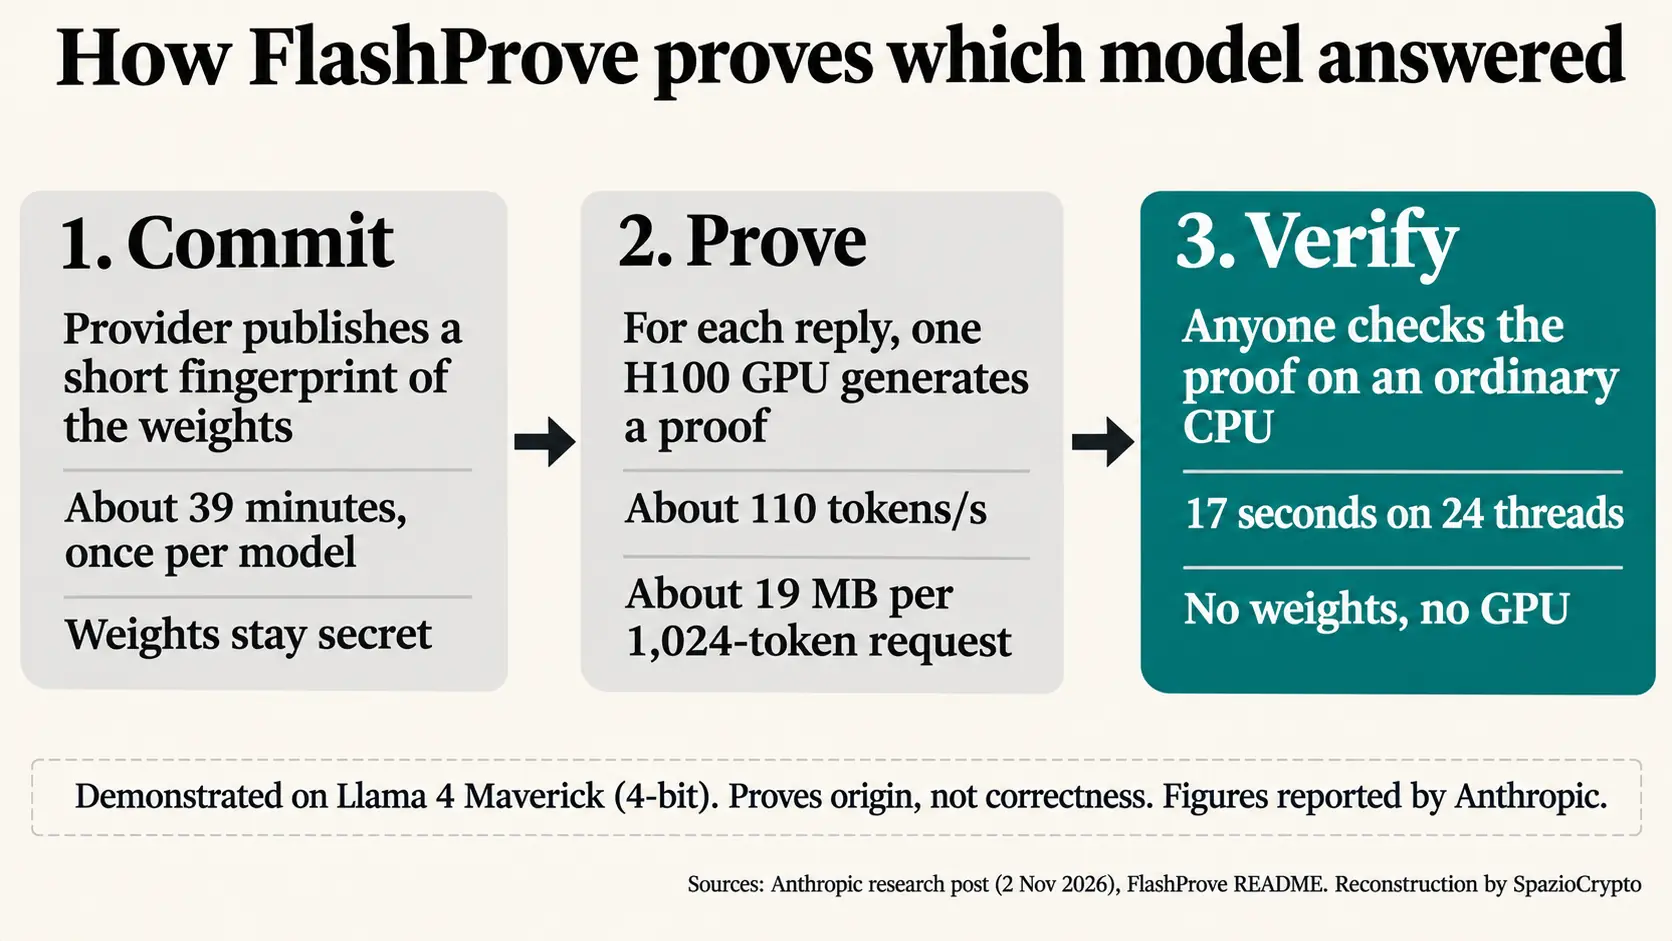
说白了,FlashProve的系统由三个步骤组成。第一步,供应商发布一个简短的模型指纹,将自身绑定到一组精确的权重上,而无需公开权重本身:根据Anthropic的数据,这一阶段每个模型只需执行一次,耗时约39分钟。第二步,针对每条响应,供应商的GPU生成一个证明,证实该token序列确实是已承诺模型的输出结果。第三步,任何人都可以在普通CPU上验证该证明,无需模型权重,也无需GPU,只需拥有模型指纹、提示词和响应内容即可。
FlashProve采用的核心技术是zkSNARK,即零知识简洁非交互式知识论证。这种密码学工具能够证明某项计算已被正确执行,同时不泄露所使用的数据。这正是加密货币领域广泛用于隐私保护和扩展性的一类技术,香港金融管理局(HKMA)及多家研究机构也在探索如何将其应用于数字支付中的隐私与合规平衡。在FlashProve框架下,模型权重、中间计算值以及专家路由选择均保持隐藏,但Anthropic明确指出,模型架构本身并不在保密范围之内。
原型的性能数据
实际上,Llama 4 Maverick是一个4000亿参数的混合专家架构模型,每个token实际激活约170亿个参数。该原型基于公开的4-bit量化版本运行。在配备24核处理器的单张H100 GPU上,证明生成阶段的速度约为每秒110个token,每次处理1,024个token的请求生成的证明文件大小约为19 MB。根据Anthropic官方博文的数据,在24线程环境下验证一个证明需要17秒,客户端还需下载约6.5 MB的承诺数据。
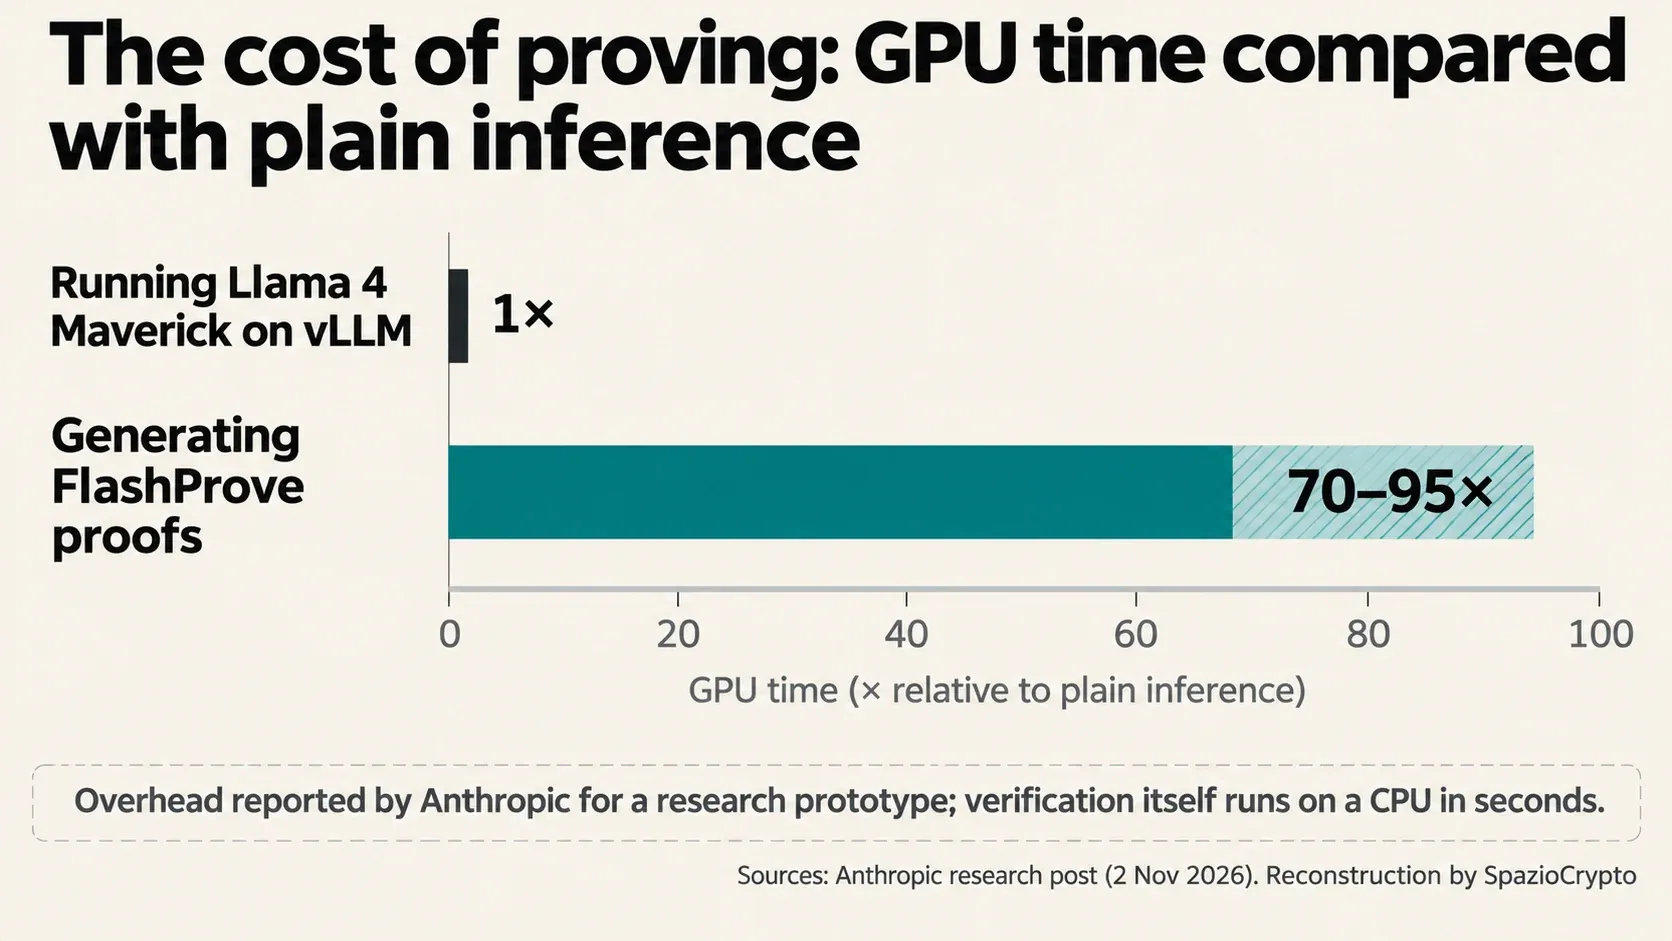
计算开销是最突出的瓶颈。Anthropic在博文中披露,生成证明所需的GPU时间是使用vLLM(业界最常用的推理引擎之一)直接运行模型的70至95倍。Anthropic在同一篇文章中将FlashProve与Attestable的方案进行比较:后者在310亿参数的稠密模型上能达到每秒53至77个token,但至今尚未发布开源库。
证明无法保证的事项
证明只能说明某个回答来自哪个模型,无法证明回答本身是否正确。Anthropic在官方文档中列出了其他局限:证明仅覆盖确定性解码,一旦引入采样(即为回答添加随机性),实际输出在某个节点之后可能与证明产生偏差。被证明的模型是完整的精确权重版本,以浮点运算得出的答案可能与其存在细微差异。此外,专门针对精度差异构造的对抗性提示不在保护范围之内,基于响应时间的侧信道攻击同样不在覆盖范围内。
实际应用层面的限制同样不容忽视。Anthropic在文档中坦言,1,024个token的上下文窗口对真实对话场景而言「相当短」。经过速度优化的C++代码没有形式化保证,也无法确保与用Lean语言编写的证明完全对应(后者才是协议数学可靠性的真正基础)。代码仓库的README措辞直接:这是一个研究产物,「不会持续维护」,也不接受外部贡献,同时未提及任何第三方安全审计。
 Anthropic
更广泛的行业影响
换句话说,对于通过经销商或平台采购AI服务的企业和公共机构而言,FlashProve目前不会带来任何直接变化:它既非商业产品,也未集成进任何商业服务。但它指明了一个方向。合同中承诺使用特定模型这件事,未来或许可以通过密码学证明加以核实,而不必依赖对供应商的信任。这与零知识证明在金融服务领域走过的路径如出一辙,Coinbase正是在这条路上推动美国反洗钱法规正式承认零知识证明技术。
 Steve Weis
这一议题还牵涉欧洲的技术依赖问题。欧盟监管机构已多次发出警告:欧盟金融体系高度依赖境外人工智能,且往往通过多层供应商间接接入。独立于供应商的验证工具,若成本大幅下降,或将成为合同条款中的强制要求。但根据目前的测试数据,计算开销高达正常推理时间的70至95倍,日常场景下根本无法落地。
FlashProve 要点梳理
已确认事项与待确认事项
- 已确认:原型以Apache 2.0协议开源,于2024年11月2日发布;在4位量化的Llama 4 Maverick模型上完成演示,上下文窗口为1,024个token;无需模型权重,仅用CPU即可在17秒内完成验证;计算开销为正常GPU推理时间的70至95倍;代码已声明不再维护。
- 未披露:外部安全审计结果;实际货币成本;是否适用于Claude API或其他模型;较长上下文场景下的耗时数据。
- 值得持续关注:能否扩展至更长上下文及其他模型架构;供应商或平台是否跟进采用;代码的独立核验情况。
更宏观的视角
换句话说,以下是我们明确声明的一项判断:FlashProve将加密世界中「不信任,只验证」的核心理念引入了人工智能领域。今天,AI服务的用户只能相信供应商关于所用模型的说法,就像过去人们不得不相信中间机构报告的账户余额一样。密码学证明将两个常被混淆的问题清晰分开:回答来自哪个模型,以及回答本身是否可靠。FlashProve只回答第一个问题,但这已是重要一步。至于Anthropic在内的各方是否会将其引入真实服务,还有待观察,正如METR评估人员进驻Anthropic内部这一透明度举措一样,结果仍是未知数。
有三个信号值得持续追踪。其一,计算开销能否从目前的70至95倍显著压缩,若无法做到,任何供应商都不可能为每条回复提供证明。其二,该方案能否扩展至长上下文场景及其他模型,包括Claude这类闭源权重模型。其三,已被原作者放弃维护的代码,是否会被其他研究团队或有意销售「可验证来源」服务的平台接手继续推进。