MiniMax于2026年10月19日发布了MiniMax M3.1 Flash,输入价格为每百万token 0.15美元,输出价格为每百万token 0.60美元。该模型目前通过公司API提供服务,模型权重将于稍后公开。对于构建智能体和软件的开发者而言,单价下降固然可喜,但完成一项任务的实际成本还取决于系统的推理深度、所调用的工具数量以及所需的纠错次数。
标价砍半两项费率,并非每张账单都减半
MiniMax官方定价页面提供了清晰的对比数据。在标准档位(输入不超过512,000 token)下,M3标准版的输入价格为每百万token 0.30美元,输出为1.20美元。Flash版将两项费率均减半。缓存读取价格从每百万token 0.06美元降至0.015美元。需要注意的是,这些是不同的计费项目:缓存价格仅适用于系统识别为可复用的token,而非全部输入内容。
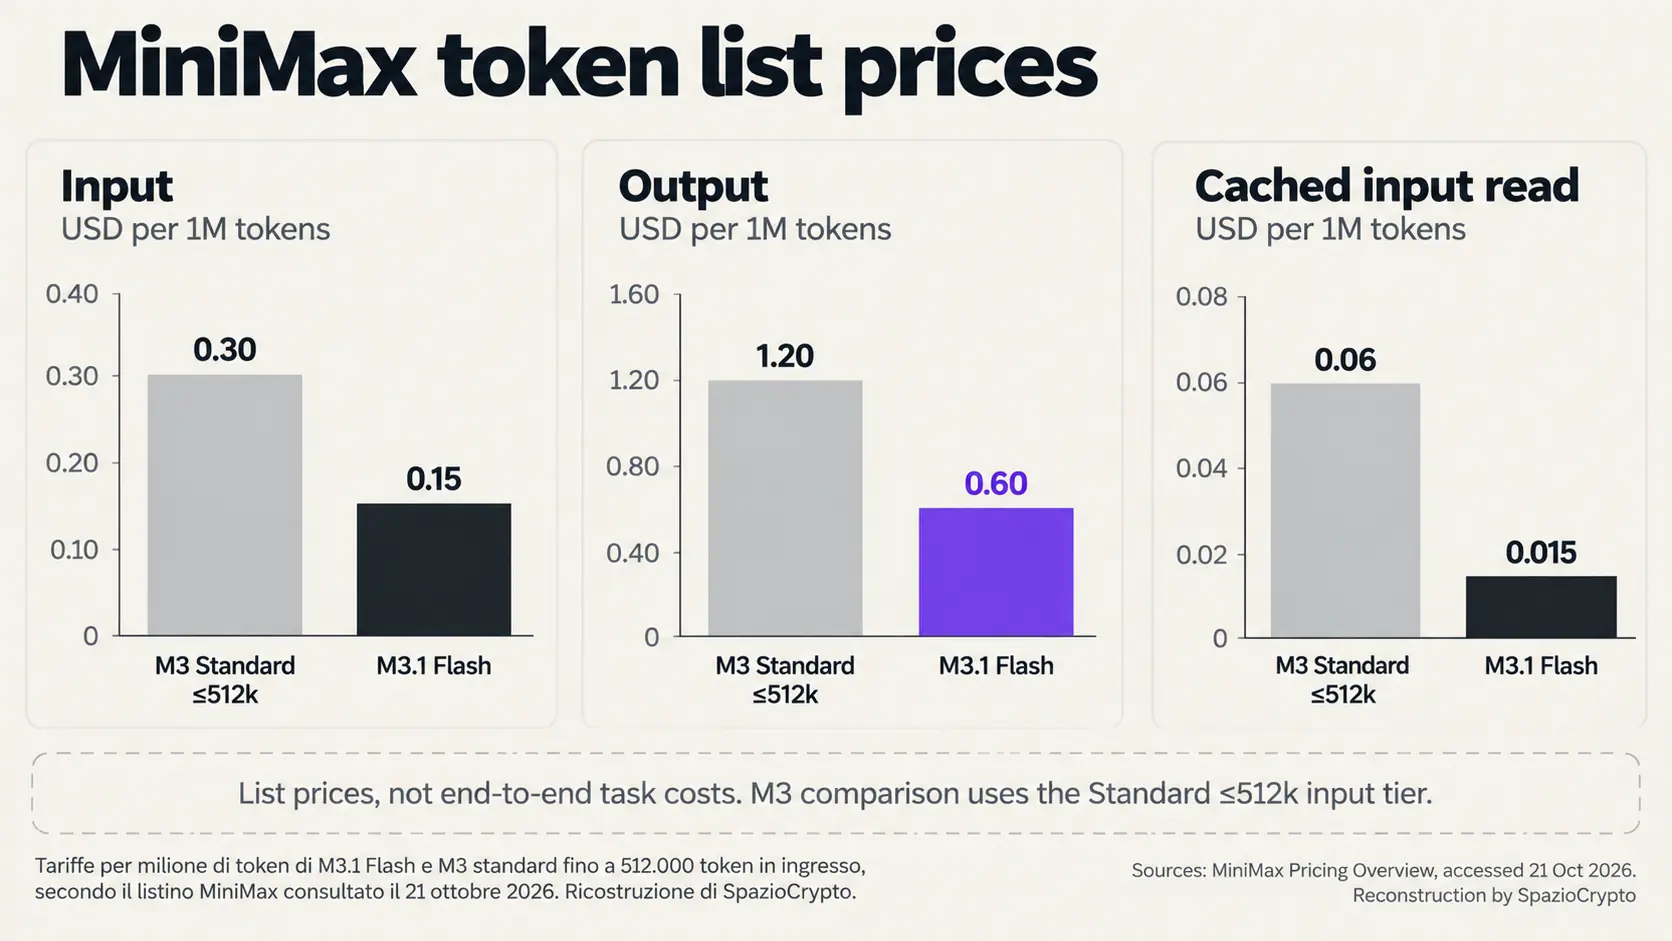
官方公告称,智能体任务的综合成本比前代降低70%。这一数字并不等同于两项主要费率减半。该数据可能涵盖了token消耗方式和任务完成逻辑的差异,但不能据此向每位客户承诺同等幅度的节省。对于追踪自动化系统落地的团队而言,这一区别至关重要:可验证的定价表与实际工作负载上的运营结果,是两个截然不同的概念。
举例说明这一差异。假设输入一百万token(均在上述档位范围内),输出十万token,不使用缓存,使用Flash的费用约为0.21美元,使用M3标准版则约为0.42美元。这是我们在相同假设消耗下测算的参考数字,不包含额外API调用、工具使用或人工干预的成本。若一个智能体重复执行某个步骤或产生更多推理过程,实际计费量会随之变化,即便单价保持不变。
推理能级可调节,无法完全关闭
说白了,兼容Anthropic接口的文档描述了五个推理级别。从low到max。对于M3.1 Flash,当参数缺省时,max为默认值。自适应推理无法通过文档中提及的关闭值来禁用:文档显示该请求会触发错误。因此,复用旧版配置进行集成的开发者需要确认新模型实际支持的行为。
根据同一份文档,提高推理级别可能产生更多推理token并增加响应延迟。因此,每个token的价格与整体响应时间描述的是两个不同维度。我们的判断是,一次有效的测试应保持目标、工具和验收标准不变,并明确记录所选的推理级别。否则,快速响应与深度处理之间的对比将失去参照基准,差异的成因也无从解释。
MiniMax M3.1 Flash: Space Performance + Bunny Speed 🚀🐰 Yes, Space Bunny - which has topped global leaderboards with 200T+ tokens - was an earlier version of M3.1 Flash. 💰Redefining the performance economics of agentic AI. M3.1 Flash achieves frontier-level intelligence across key tasks such as Cowork (Automation-Bench: 62%; ALE: 30%), Coding (DeepSWE: 74%) and Visual Reasoning (BabyVision: 91%), at 1/3 the cost of M3 and 3x the speed. API pricing (flat rate): $0.15 / $0.60 per 1M input/output tokens, with cache reads at $0.015 / 1M tokens. Model weights will arrive on Oct 23. API: https://t.co/fHRdSV73Hr M Plan: https://t.co/XfJWSyauda MiniMax Code for desktop: https://t.co/SGmLTI2HQm
,MiniMax (official) (@MiniMax_AI) October 19, 2026
官方产品目录显示。该模型支持一百万token的上下文窗口和多模态能力。上下文容量的声明并不保证每份长文档都能被正确处理。对于通过API接口集成模型的开发者。核心问题在于如何在多步骤之间保留必要信息。一个非常大的请求可能包含冗余或相互矛盾的指令:模型能够接受输入。并不意味着它总能从中选取正确的内容。
基准测试范围有限,需审慎解读
实际上,MiniMax公布了编程、计算机操作与安全领域的测评结果。根据官方新闻稿,相关数据包括:DeepSWE v1.1上得分73.7%、OSWorld V2上得分61.7分,以及CyberGym上得分82%。这些均为厂商自行发布的数据。新闻稿还列出BankerToolBench得分76.2分、Agents' Last Exam得分29.6分。各项测试考察的任务性质不同,无法叠加换算为统一的整体可靠性百分比。代码问题上的高分,并不足以证明该模型在处理文档或金融权限时同样零差错。
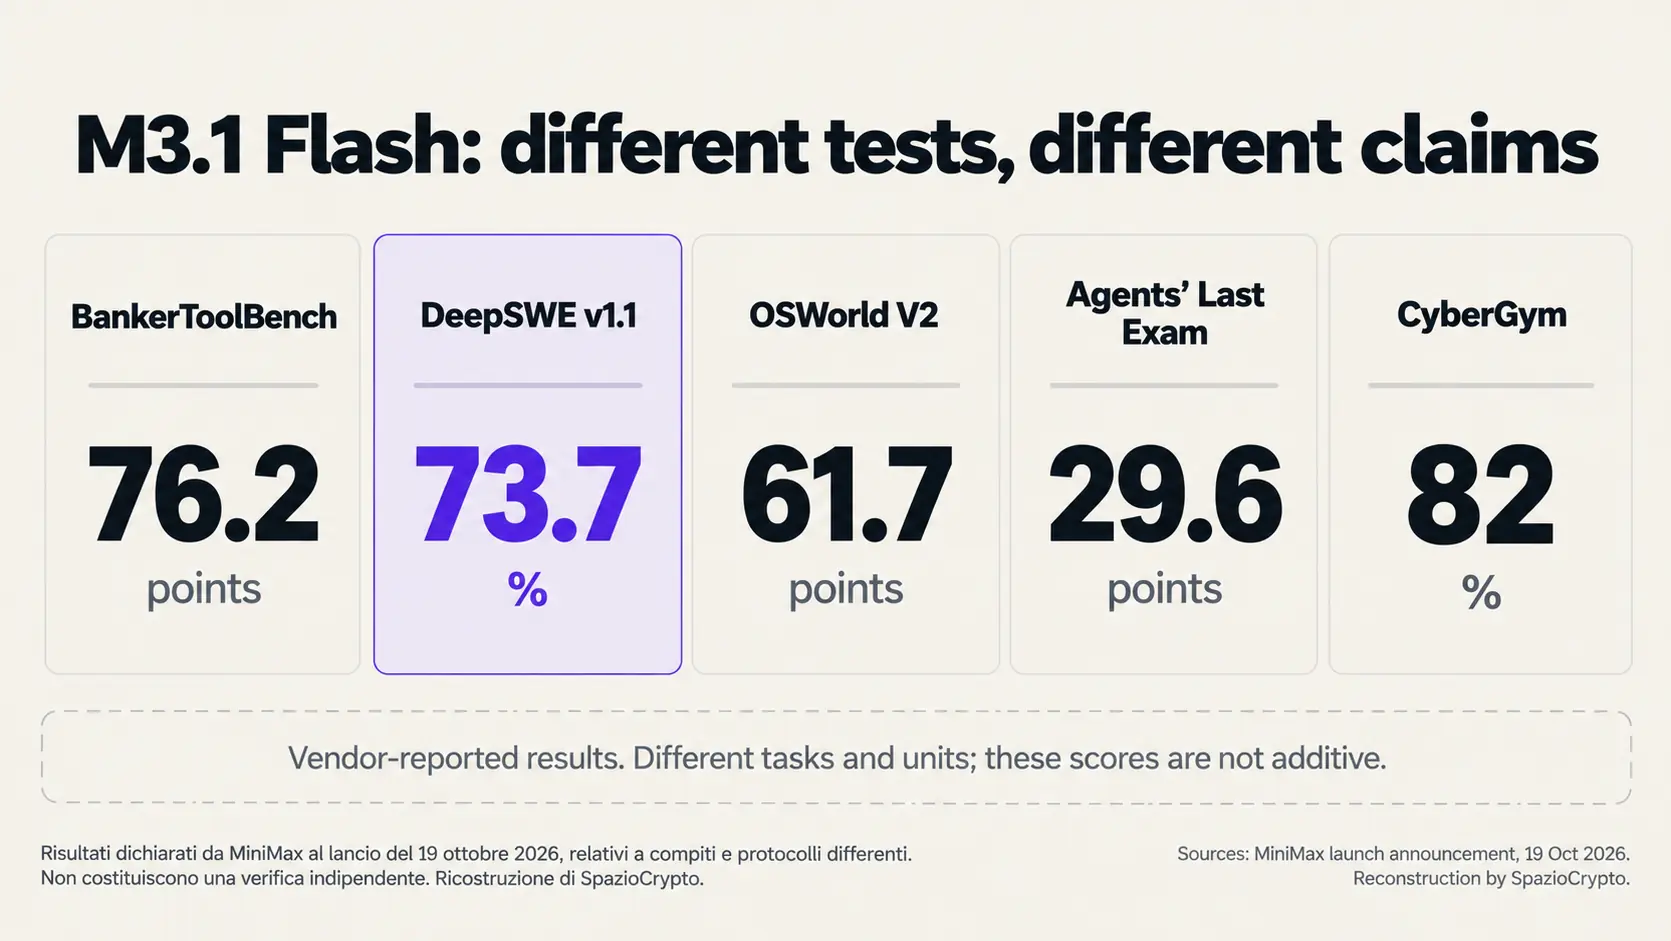
速度指标同样需要加注说明。该公司声称在特定条件下每秒超过200个token,中位数在170以上。这是基于其自有基础设施的数据,并非完成每项流程所需时间的保证。每秒生成的token数量,并不自动涵盖各次调用之间的等待时间、外部服务的响应延迟,以及人工审核结果所耗费的时间。
这一区分在模型基准对比中同样重要。任何数字都需注明测试版本、所用工具和推理配置。我们认为,针对Flash的有效对比,需要设定相同的目标和明确的预算。若将发现漏洞的能力作为模型整体可靠性的证明,则混淆了所测任务与该模型可能承担的其他工作之间的本质差异。
Artificial Analysis在另一套测试集上提供了独立的外部参考:该机构在其专项发布帖中,以最高推理配置为Flash打出Intelligence Index 42分,并报告其每任务成本约为0.22美元,而M3约为0.51美元。这是来自非厂商方的第三方评估,并非我们的复现结果。该成本仅适用于其指数所涵盖的任务与方法,不代表交由该模型处理任意工作的通用单价。
访问服务与掌控权重是两个不同阶段
10月19日的发布公告列出三个接入渠道:MiniMax API、M Plan和MiniMax Code。新闻稿未注明权重文件的发布日期,将其推迟至后续时间;而MiniMax官方LinkedIn页面发布的帖子则指向10月23日。这是一项已宣布的时间节点,并非已完成的发布。因此,可用的服务与可下载的模型文件仍属两个独立阶段。将Space Bunny认定为该模型初始版本,系MiniMax的自我声明,这一匿名代号本身并不构成独立评估。
MiniMax-M3.1-Flash scores 42 on the Artificial Analysis Intelligence Index, 13 points higher than MiniMax-M3 and less than half the cost per task. It scores level with GLM-5.3-Flash but behind DeepSeek V4.1 Flash 1017
,Artificial Analysis (@ArtificialAnlys) October 19, 2026
MiniMax-M3.1-Flash is @MiniMax_AI's new Flash reasoning… pic.twitter.com/bEelNegMKP
我们的判断是,两种模式支持不同类型的验证。托管服务让用户能够立即测试界面表现与响应行为。权重文件的公开则将带来另一种可能:依据随附许可证的约定,下载并保存模型文件,研究更多配置选项。新闻稿并未说明该许可证的具体内容,也未提及所需硬件规格。在文件正式发布之前,若宣称Flash已具备完整的独立可用性,则是对一个尚在承诺阶段的步骤的超前定性。
有效成本核算应以完成任务为准
换句话说,从辅助编程过渡到智能体编程的过程中。成本会分散在多次尝试之间。一个智能体可能需要读取代码库。提出修改方案、执行测试,并在某次检查失败后返回修改代码。这是我们自己构建的操作示例,并非基于Flash的实测结果。经济对比应当计算整个序列直至工作被验收为止的总成本。包括那些未能产出可用方案的执行次数。
独立评估的价值,也在于这些序列是否可观测、可复现。我们的建议是:记录每次执行的结果。消耗量、重试次数和修正次数,同时保持验收标准的一致性。降低推理级别或许能缩短单次等待时间。但也可能增加后续修订的频次。这是一个需要在具体工作负载上加以验证的假设。而非我们在未经测量的情况下对模型行为的判断。
MiniMax M3.1 Flash 要点梳理
- 已确认:10月19日正式发布,公开定价及托管接入文档均已提供。
- 尚待核实:LinkedIn公告所称10月23日权重文件的实际发布,以及每项流程的具体节省成本。
- 需持续关注的指标:同等任务下的资源消耗、所需修正次数,以及承诺交付产出物的实际可用性。
更深层的解读
换句话说,我们的判断是:应用人工智能领域的竞争。正从单次响应的价格转向可接受的执行成本。Flash的定价方案压低了一个可量化的成本项。但并不能消除对结果进行验证的必要性。一个模型只有在同等输出要求和执行条件下。同样能减少需要修正的环节,才算真正具备实用价值。
接下来,几个关键信号值得重点观察:权重文件能否按照公告时间节点如期发布、基于明确配置的可复现对比测试结果,以及在典型任务上的实测数据。同样重要的是,当系统遭遇失败时的表现:它究竟是主动提示边界、及时停止任务,还是持续消耗算力。这些差异,是每百万Token的定价无法呈现的,却恰恰决定了一个可靠智能体的最终实际成本。