2026年10月27日,Google DeepMind正式发布Genie 4,这是一款能够实时生成可探索环境的世界模型,音效、音乐与对话均与画面同步生成。用户通过键盘和鼠标在场景中移动,并可在模拟运行期间用自然语言修改场景内容。目前仅有少数受邀测试人员可以体验。Google AI Ultra订阅用户(Project Genie)及API合作伙伴的访问权限被标注为「即将推出」,但未给出具体日期。DeepMind官方也明确声明,物体交互、场景连贯性和物理模拟仍存在不稳定情况。
本文内容来源于DeepMind官方公告(由Raia Hadsell、Diego Rivas和Hang Qi署名)、Google博客以及模型介绍页面。X平台的原帖及YouTube演示视频未能直接访问,相关文字内容通过AI Lately发布的嵌入内容核实。Genie 3的技术规格数据来自The Decoder于2025年8月发布的报道。
This is Genie 4, our most realistic and interactive world model yet. 🌐
,Google DeepMind (@GoogleDeepMind) October 27, 2026
Explore dynamic environments in real time to see how the scene responds, sounds, and how the people in it move, react, and speak. pic.twitter.com/6mmSUm9BBO
Genie 4能做什么
Genie 4是一款世界模型。它生成的不是供观看的视频片段,而是逐帧响应指令的交互环境。用户可以从一段文字描述或一张参考图片开始。后者作为第一帧画面。接下来通过键盘控制移动和镜头视角进行探索。在会话过程中,用户可以更改天气、移动镜头角度、添加人物或物体。根据DeepMind官方介绍。内置的Gemini模型会将每条指令适配到当前场景。并在两条指令之间保持世界运转。
该模型依托Gemini系列。Gemini Omni负责将场景锚定于真实世界的外观与行为,其他Gemini模型则处理维持模拟连贯性的推理逻辑。这与Google正在企业办公场景中推进的Gemini企业智能体属于同一技术家族,后者同样处于受限预览阶段。
核心突破:原生音频生成
说白了,DeepMind将Genie 4定位为首个能够原生生成音频的实时世界模型。每个环境都有专属的背景音效和配乐,角色可以开口说话,对话内容会随指令和场景事件自动调整。
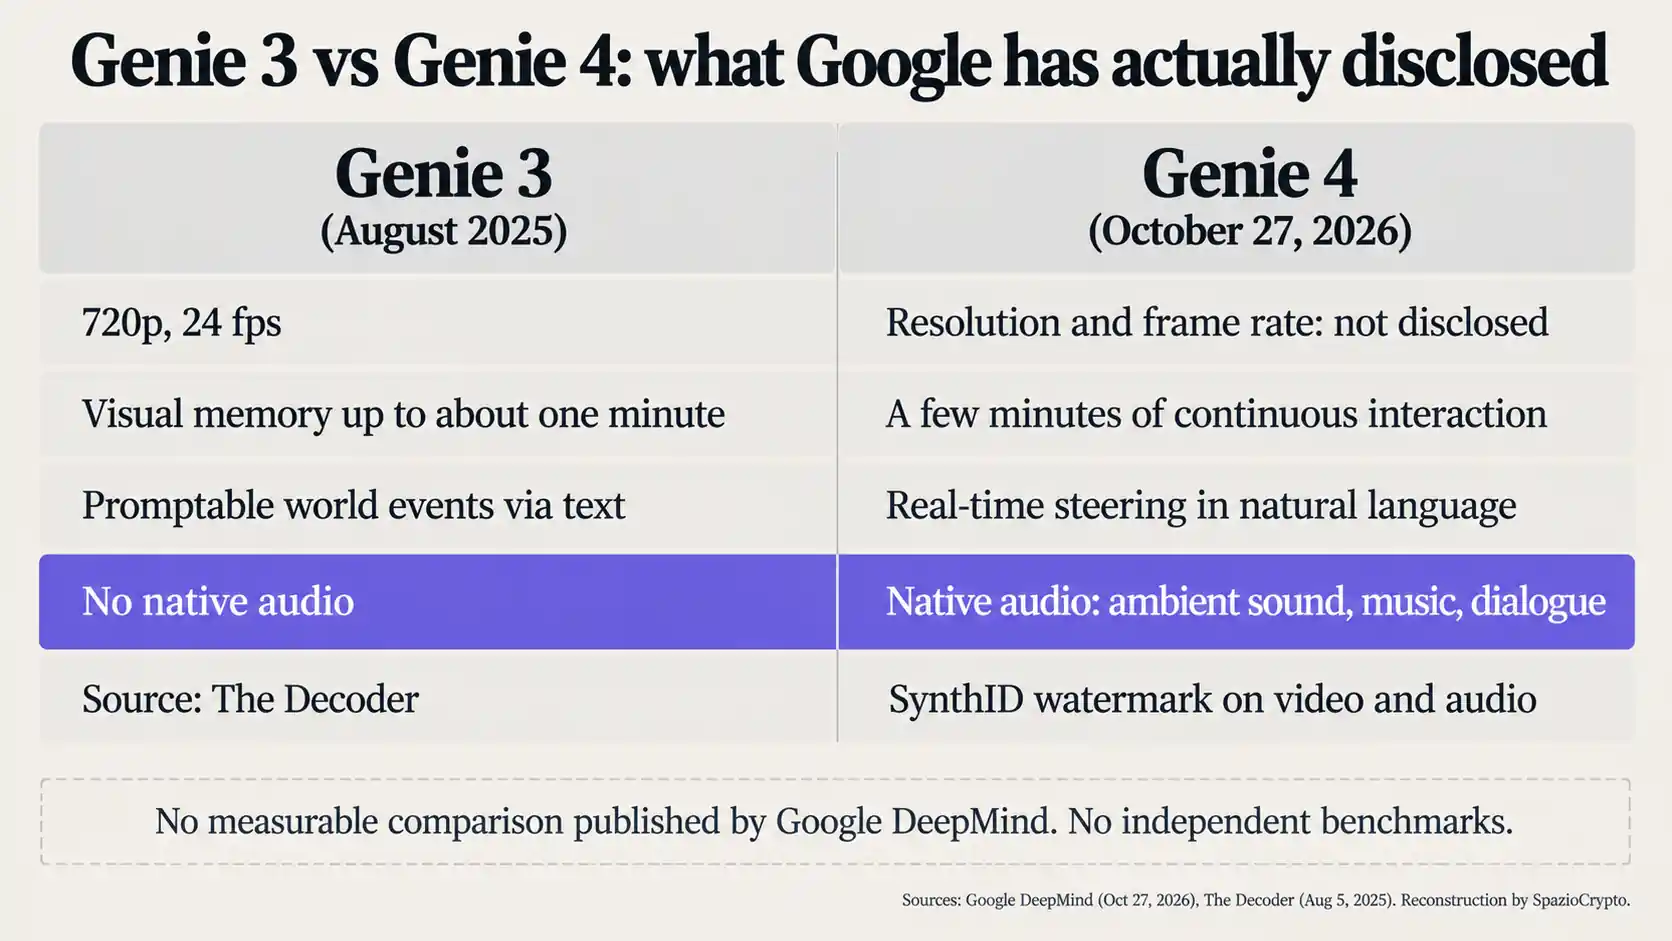
这正是Genie 4与2025年8月发布的Genie 3之间的关键差异。根据The Decoder的报道,Genie 3能够以720p分辨率、每秒24帧生成场景,具备长达一分钟的视觉记忆,并支持通过文字触发场景变化(即所谓的“promptable world events”),但不包含音频。Genie 4方面,DeepMind未公布分辨率、帧率或持续时长等技术指标,也未提供与上一版本的可量化对比数据。模型介绍页面仅提及「数分钟的连续交互」。
交互原型,而非视频生成器
实际上,理解这一区别对于判断其实际用途至关重要。视频生成器输出的是封闭的片段,而Genie 4生成的是响应用户操控的动态场景。DeepMind列举了若干具体应用场景:导演可在实时模拟中拍摄多条分镜并反复调整;图片记者可尝试将单张存档照片转化为可探索的环境;游戏开发者可从文字描述出发测试视觉风格和游戏机制;企业合作伙伴可快速生成应用场景原型。这些工作流与创作者现有工具形成互补,例如Adobe和NVIDIA正在加速推进的AI创作工具。
最具战略意义的领域是智能体与机器人仿真。根据DeepMind公告,Gemini 3.8 Flash能够逐帧观察场景,将目标拆解为多个步骤,逐一验证,并在环境变化或用户介入时动态修正计划。另一项演示中,Gemini 4 Argon与Genie 4协作,完成了一项涉及Apptronik公司Apollo机器人的任务,内容包括机器人操作与一局跳棋对弈。在生成世界中训练智能体,与NVIDIA和LG布局的物理AI本质上是同一路线。但演示与实际产线之间的距离,工厂里的人形机器人已经说明了一切。
DeepMind亲口承认的局限
这份公告并未回避薄弱之处。视觉细节与物体持久性在长时会话、多次文字修改或场景切换中容易出现偏差。复杂物理交互、实时音频精度、可读文字、空间准确性和长期一致性,目前仍属研究课题。
模型说明页面还列出另外三项限制。其一,多智能体与多用户在同一环境中的协同交互尚未实现。其二,真实地点无法被精确重建。其三,会话时长极为有限,仅支持数分钟,无法进行持续的长时运行。说明中特别注明,所有展示录像均为真实会话的剪辑版本,结果仅供参考。目前没有任何基准测试,也没有独立第三方评估,公众所见仅为官方演示。
谁能体验,何时开放
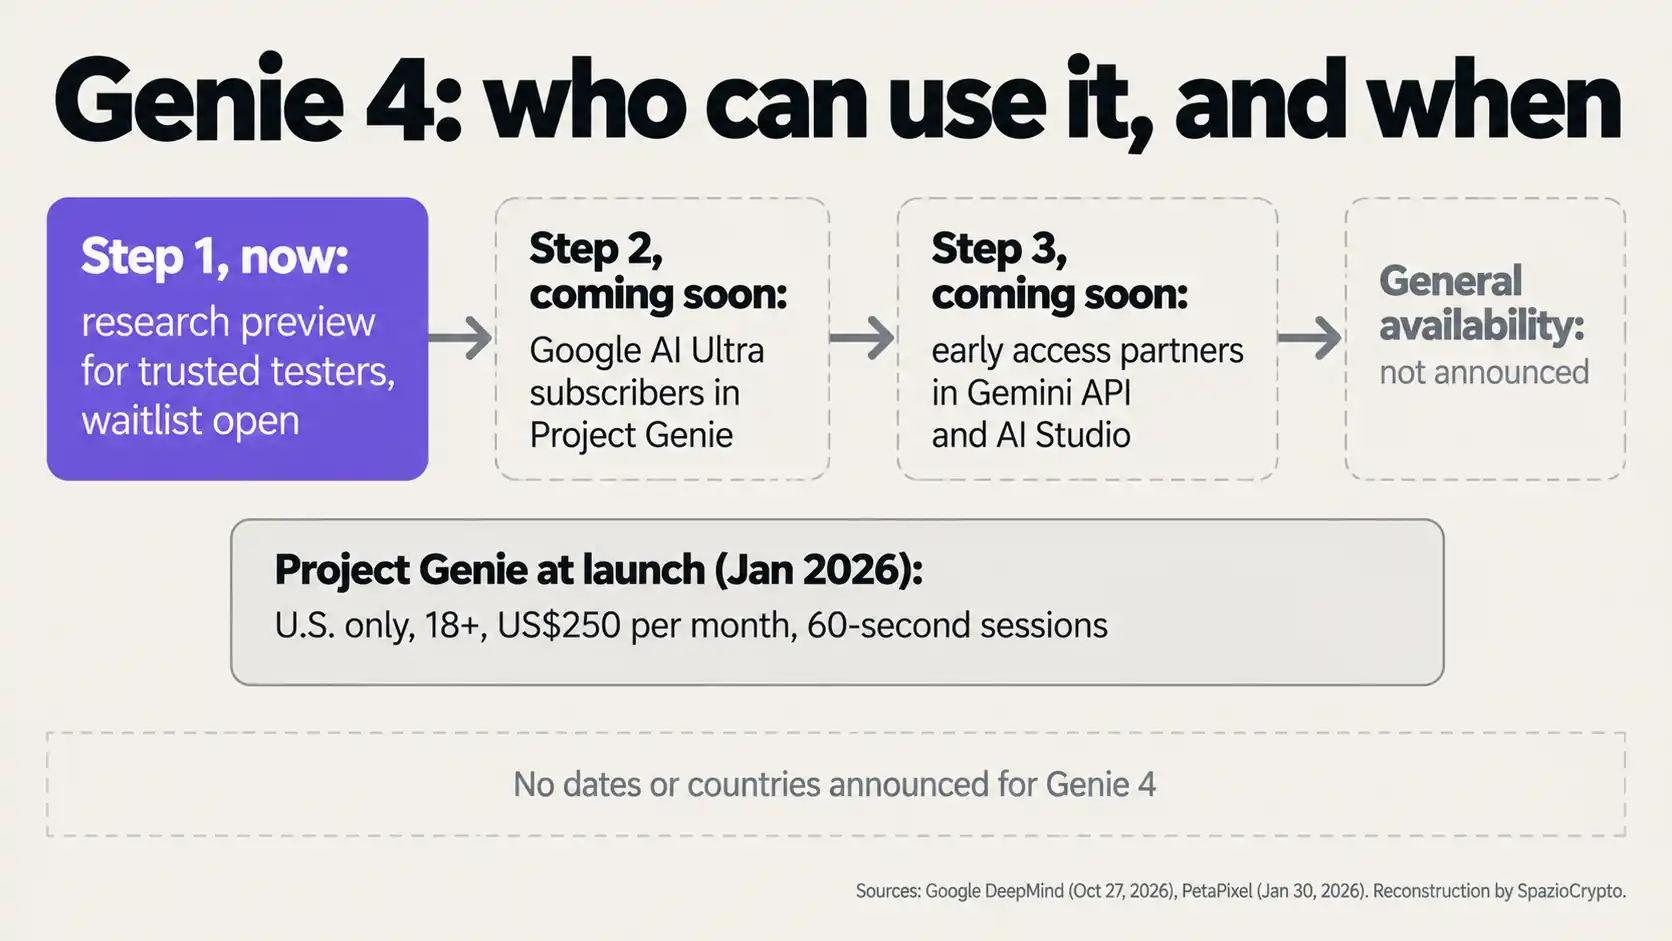
换句话说,简短的回答是:目前几乎无人可用。该模型目前处于受信测试者的研究预览阶段,候补名单已开放申请。此后将向Project Genie框架内的Google AI Ultra订阅用户开放,以及持有Gemini API和AI Studio早期访问权限的合作伙伴。具体日期与上线地区均未披露。
此前的案例有助于校准预期。据PetaPixel报道,Project Genie于2026年1月29日随Genie 3一同推出,发布时仅向美国地区年满18岁的Ultra订阅用户开放,月费250美元,每次生成时长限制为60秒。目前尚不清楚上述限制是否已有所放宽。对于中文区用户而言,当前并无已确认的访问路径。透明度方面,DeepMind表示,Genie 4生成的所有视频与音频都将嵌入SynthID数字水印,这一问题的重要性不言而喻,尼康曾因生成式AI内容问题取消一则获奖视频的资格,即为前车之鉴。
Genie 4要点速览
已确认与未确认事项
- 已确认:具备原生音频的实时世界模型、会话中可通过文字修改场景、受邀测试者预览阶段已开放、视频与音频均嵌入SynthID水印,以及官方公布的物体、物理、音频和时长方面的局限。
- 未披露:分辨率、帧率、具体分钟时长、上线国家与日期、API定价,以及任何基准测试或独立评估结果。
- 值得持续关注:Ultra订阅用户在Project Genie中的访问开放进度、API合作伙伴计划,以及首批针对一致性与物理模拟的独立测试结论。
更大的视角
换句话说,我们认为,Genie 4将生成式AI的竞争焦点从「片段」转移到了「世界」。视频是用来观看的,环境是用来使用的:体验一个游戏关卡,拍摄一段场景,训练一个智能体。正因如此,官方披露的局限比普通视频生成器更具实质意义。一个物体在短片中消失。不过是视觉瑕疵;而在机器人或智能体仿真器里,这意味着错误的数据输入。Genie 4的价值在于快速原型验证,可靠仿真尚需时日。
有三个信号值得持续跟踪。第一,访问权限何时、以何种会话时长向测试者以外的用户开放。第二,针对物体持久性、场景一致性与物理模拟的独立评估何时出现,目前这类评估完全缺席。第三,与代表用户在计算机上执行任务的智能体的协同使用,能否从演示阶段走入真实工作流程。